Коли бізнес підключає AI-агента до вебу, слово free звучить дуже приємно. Здається, ось воно: агент сам читає сайти конкурентів, збирає ціни, перевіряє наявність товарів, готує дослідження для маркетолога.
А потім приходить рахунок. І часто він не за сам пошук, а за те, що агент приніс мовній моделі на читання.
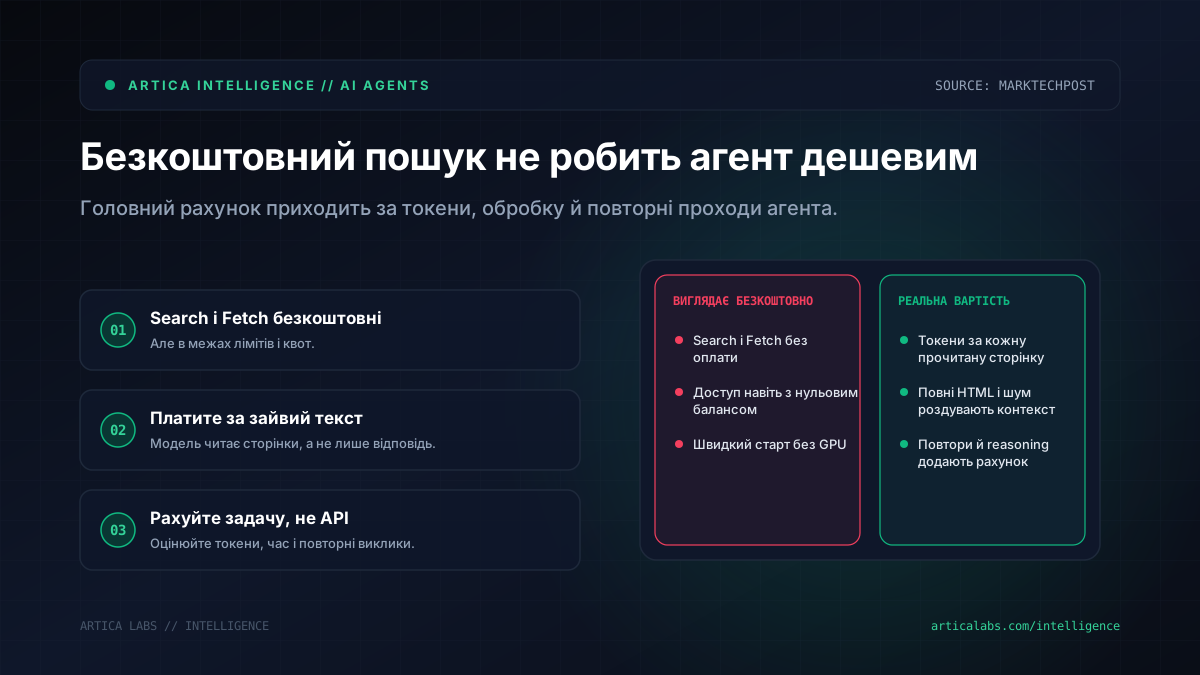
Як пише MarkTechPost, TinyFish зробила Search і Fetch безкоштовними в межах лімітів. Але в цій історії є друга частина економіки: кожна сторінка, яку агент прочитав, перетворюється на вхідні токени для моделі. Далі додаються reasoning, відповідь моделі й повторні проходи в агентному циклі. І тут починається найцікавіше.
Безкоштовний запит не робить задачу дешевою автоматично
TinyFish тепер дає безкоштовний Search у межах 30 запитів на хвилину і 500 на годину. Fetch безкоштовний до 150 URL на хвилину і 1 000 на день. Обидва працюють навіть із нульовим балансом Wallet.
Доступ є через REST, Python і TypeScript SDK, CLI та MCP. Під капотом компанія використовує власну інфраструктуру з браузерним флотом для рендерингу сторінок і взаємодії з сайтами. Локальний GPU для цього не потрібен.
На зрізі Artificial Analysis від 28 вересня 2026 року TinyFish Search отримав 71 бал і показав $9.30 за 1 000 benchmark tasks, якщо рахувати модельну частину. Це найнижча загальна вартість серед 12 показаних конфігурацій.
Але є нюанс. Результат 71 був найнижчим серед відображених систем, тоді як Perplexity Search medium мав 80. Час на задачу в TinyFish склав 59 секунд, це другий найдовший показник у таблиці. Тобто дешево, але не завжди швидко й не завжди з найкращою якістю.
Є ще один обмежувач: у продукті Agent вбудовану модель TinyFish не можна замінити. Для частини команд це нормально. А от якщо ви хочете тонко підбирати моделі під різні задачі, доведеться прийняти компроміс.
Найбільше грошей з’їдає не пошук, а зайвий текст
MarkTechPost наводить показовий приклад із тесту TinyFish на 45 URL. Для однієї статті Daily Mail із тілом приблизно 4 300 символів різні провайдери повернули дуже різний обсяг тексту.
TinyFish Fetch віддав 4 737 символів, приблизно 1 184 токени. Firecrawl Scrape повернув 171 095 символів, орієнтовно 42 774 токени. Exa Contents і Tavily Extract теж віддали значно більше: 65 793 і 46 433 символи відповідно. Parallel Extract повернув лише уривок на 600 символів, тому напряму порівнювати його з повними витягами нечесно.
Це один сайт, а не універсальний закон. Але для бізнесу висновок простий: якщо агент тягне меню, коментарі, рекламу, футери й технічний шум, ви платите моделі за читання сміття.
Уявімо інтернет-магазин, який щодня перевіряє ціни конкурентів. Якщо агент бере повні сторінки товарів без очищення, контекст забивається дуже швидко. Сторінка на 42 774 токени займає приблизно третину 128K-вікна. Три такі сторінки — це вже близько 128 322 токенів, майже без місця для інструкцій, історії діалогу й відповіді.
Ми б починали не з вибору найдешевшого API, а з кількох приземлених перевірок:
- порахувати середній розмір сторінки після Fetch: символи, токени, частку корисного тексту;
- не передавати моделі повні HTML-сторінки, якщо достатньо ціни, заголовка, опису чи таблиці;
- тестувати провайдера на своїх сайтах, бо новини, маркетплейси й B2B-каталоги поводяться по-різному;
- рахувати вартість задачі, а не ціну одного API-запиту;
- перевіряти ліміти й затримку, особливо для процесів у реальному часі.
Для агенції це може означати дешевше дослідження ринку. Для клініки — моніторинг регуляторних оновлень. Для служби доставки — перевірку сторінок партнерів. Сценарії нормальні, але ми б не ставили такий інструмент у продакшн без маленького пілота: 50–100 типових задач, замір токенів, часу, якості відповіді й кількості повторних викликів.
Безкоштовний пошук приємний. Та справжня економія починається там, де агент читає менше зайвого й точніше дістає потрібне.