Якщо ваш бізнес розробляє MVP, SaaS або навіть внутрішню CRM, швидкість команди впирається не тільки в написання коду. Часто все зупиняється на рев’ю. Розробник уже закрив задачу, а зміна чекає перевірки день, два, інколи тиждень.
Для власника це звучить як технічна дрібниця. Насправді наслідки дуже приземлені: релізи зсуваються, баги накопичуються, команда витрачає години на ручну рутину замість рухати продукт далі.
І тут починається найцікавіше. AI у code review вже не зводиться до сценарію «закинули файл у чат і спитали, чи все добре». Як пише DOU, команди тестують схеми, де один агент пише код, інший перевіряє, третій оцінює якість зауважень, а тести запускаються ще до pull request.
AI-агенти вже підстраховують рев’юерів
Причина проста: коду стає більше. У GitLab, за даними DOU, поставили ціль вийти на 500 мердж-реквестів на інженера на місяць до кінця року. Це не обов’язково про те, щоб «вижати більше з людей». Радше про спробу прибрати тертя там, де воно з’їдає дні. Бо один MR інколи дивляться від двох до десяти людей.
У Kube-DC масштаб інший: проєкт на 1,2 млн рядків коду, над яким працювали троє замість запланованих 15. Засновник Kube-DC Володимир Цап описав цикл, де модель писала й тестувала код, інша шукала проблеми, перша виправляла, і так по колу. Для складного core-компонента таких повторів було близько 140 за три доби. Людина, найімовірніше, втомилася б значно раніше.
Та AI не скасовує здоровий глузд. Він добре ловить механіку: невідповідність правилам, крайові сценарії, проблеми в тестах, порушення внутрішніх конвенцій. Уявімо інтернет-магазин. Агент може перевірити, чи нова логіка промокодів не ламає оплату. Або клініку: чи зміна в адмінці не відкриває зайві дані пацієнта. Але питання, чи потрібна ця фіча бізнесу саме зараз, модель не вирішить за власника продукту.
Готовий сервіс чи власний агент: залежить від зрілості команди
У статті DOU є показовий контраст. У GitLab взяли вбудованого AI-рев’юера і додали локальні етапи перевірки. У Preply порівнювали власний рев’юер із готовими рішеннями на однакових pull request. В одному тесті було сім навмисних порушень внутрішніх DDD-правил: власний рев’юер знайшов усі сім, CodeRabbit показав три у звичайних коментарях, а ще чотири позначив як мінорні.
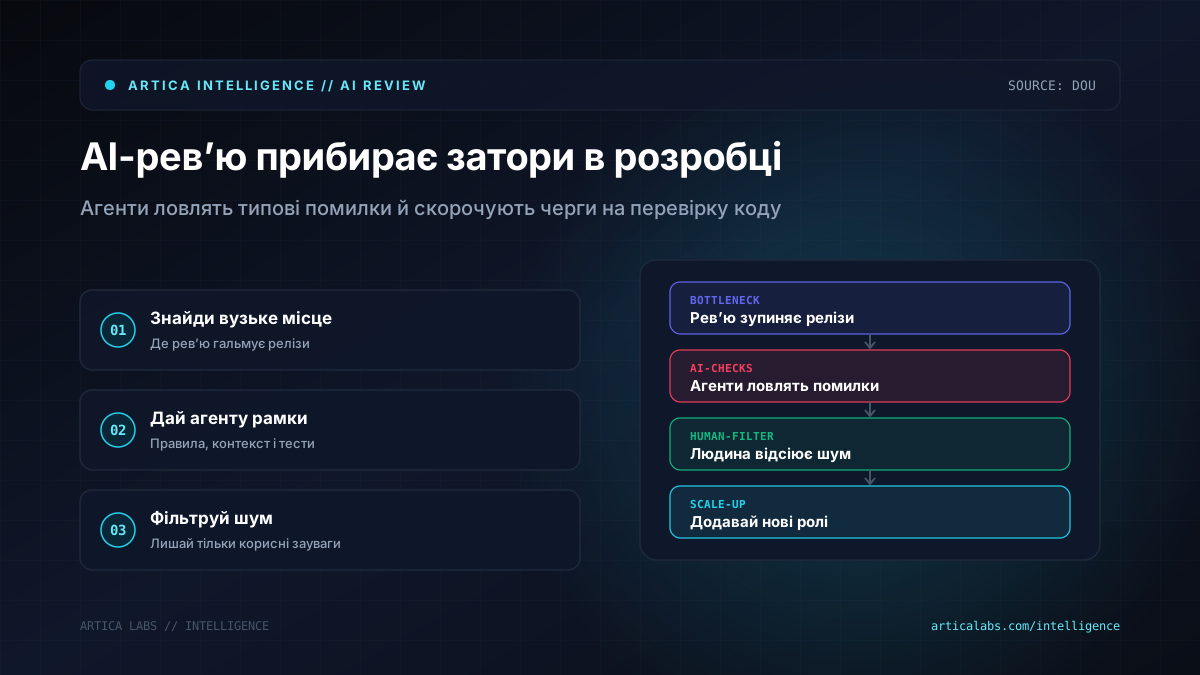
Для бізнесу висновок доволі практичний. Якщо у вас невелика команда або продукт тільки стартує, починайте з готових інструментів. Не треба в перший місяць будувати «власний GitLab Copilot». Спершу подивіться, де саме болить: після релізу вилітають баги, рев’ю довго висить без руху, код пишуть у різних стилях, тести покривають не все.
Мінімальний план може бути таким:
- взяти 20–30 старих pull request із відомими проблемами й перевірити на них AI-рев’юер;
- не доручати LLM те, що краще роблять лінтери, типізація та автотести;
- описати правила команди в гайдлайнах і давати агенту тільки потрібний контекст;
- запускати перевірки однаково локально і в CI, наприклад через підхід local parity, який у джерелі пов’язують із Dagger;
- порівнювати готові рішення з власними прототипами на тих самих задачах.
Підводний камінь тут один, але неприємний: шум. Коли агентів стає багато, вони починають знаходити все підряд. Стилістику. Ризики, яких може й не бути. Дублікати тих самих зауважень різними словами.
Тому потрібен фільтр. Це може бути головний агент, який відсіює зайве, або людина, яка дивиться тільки на фінальний набір коментарів. Інакше команда швидко перестане читати ці підказки, навіть якщо серед них є справді корисні.
Наша позиція проста: AI-рев’ю має сенс не як модна іграшка для розробників, а як спосіб прибрати затори в доставці продукту. Почніть з малого: один агент, один тип перевірок, один репозиторій. Коли стане видно користь і межі, можна додавати ролі для security, архітектури, бази даних чи інтерфейсу. Так AI вбудовується в процес, а не перетворюється на ще один хаотичний чат поруч із командою.