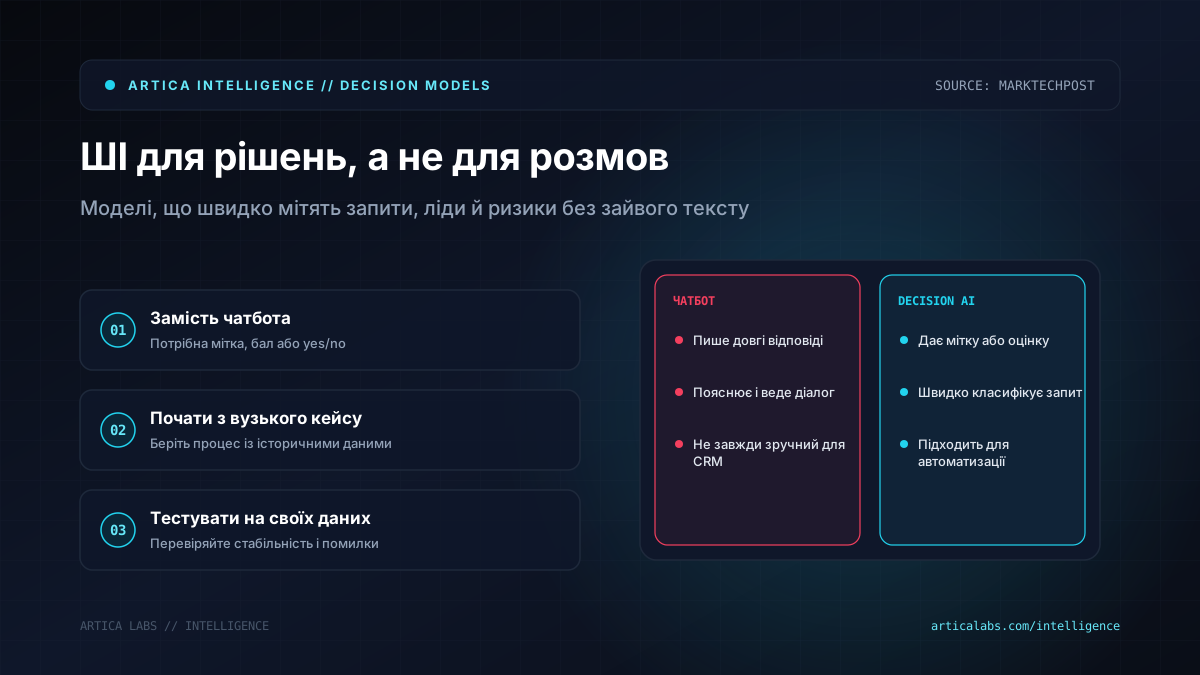
Бізнесу не завжди потрібен чатбот, який уміє гарно пояснювати. Частіше потрібна система, що швидко відповість: цей запит терміновий чи ні, лід гарячий чи холодний, платіж підозрілий чи звичайний. Без довгих абзаців і «людського тону». Просто рішення, яке можна передати в CRM, службу підтримки, кабінет лікаря або складську систему.
Саме тому навколо decision models стільки руху. MarkTechPost пише, що після запуску TypeSafe Jev 15 вересня 2026 року приблизно за чотири тижні з’явилося щонайменше 20 альтернатив. І тут починається найцікавіше. Це вже не про «поговорити з AI», а про те, щоб дати моделі набір дозволених відповідей і отримати мітку, бал або ймовірність «так/ні».
AI, який не балакає, а ставить мітки
Jev від TypeSafe працює як модель для типізованих рішень. Ви передаєте їй стан, скажімо тикет клієнта або рядок логу, і ставите питання у форматі Choice, Score або yes/no. Модель не пише текст, а оцінює варіанти.
У Jev контекст 64k токенів, ціна в документації — $0.042 за 1 млн вхідних токенів, вихід не тарифікується. Але є й обмеження: лише текст, закриті ваги, доступ через waitlist, немає опублікованого розміру моделі, self-hosting і fine-tuning.
Альтернативи намагаються закрити ці прогалини. Cloudflare Clef і Clef-flash працюють через Workers AI, приймають текст, JSON і до 4 зображень у запиті. Perplexity pplx-decider читає текст, JSON і до 8 зображень на питання, а flash-версія коштує $0.01 за 1 млн вхідних токенів. OpenAI випустила Decisions API у публічній бета-версії, але без сумісності з Jev API і без опублікованих бенчмарків.
Є й open-source напрям. Strands Decider від AWS Strands Labs можна підняти локально, Kev має варіанти від 0.8B до 27B, Mapika Decider доходить до 35B-A3B, а легші моделі на кшталт Von, Laya чи GLiNER2.5-Decide цікаві для CPU або edge-сценаріїв. Розкид великий: від 287M параметрів до 35B-A3B. Вибір уже не один. Але й простого «беремо найновіше» тут немає.
Де це може спрацювати в реальному процесі
Уявімо інтернет-магазин. Модель може розкласти звернення за типами: повернення, гарантія, доставка, скарга. Не відповідати клієнту замість оператора, а передати мітку в helpdesk і виставити пріоритет.
У клініці така модель може попередньо визначати тип звернення пацієнта за описом симптомів і скеровувати його до потрібного адміністратора. В агенції — оцінювати ліди за ймовірністю купівлі. У службі доставки — позначати ризикові інциденти в операційних логах.
Практичний старт ми бачимо так:
- взяти один вузький процес, де вже є історичні дані й правильні відповіді;
- порівняти 2–3 моделі на власній вибірці, а не на красивих vendor-бенчмарках;
- перевірити стабільність: чи не змінюється відповідь від порядку опцій або формулювання;
- залишити людину в циклі там, де помилка дорого коштує.
Підводні камені тут серйозні. MarkTechPost прямо нагадує, що більшість результатів у таблицях — self-reported. У сторонньому прогоні Respan Jev мав accuracy 0.932, Tev1 — 0.901, Kev — 0.833, а Laya й Von помітно просіли. Але й цей тест робив постачальник конкуруючої моделі. Тобто як орієнтир це корисно, як істина — ні.
Найбільший ризик для бізнесу в іншому: модель повертає результат у правильному форматі, але по суті помиляється. Автоматизація виглядає охайно, звіти збираються, процес наче працює. А потім виявляється, що гарячі ліди йшли не туди, скарги клієнтів отримували низький пріоритет, а підозрілі платежі проходили як звичайні.
Тому decision models краще запускати не як магічну кнопку, а як контрольований шар у n8n, Make, CRM чи внутрішньому SaaS. З логами, тестами, порогами впевненості й ручною перевіркою на старті.
Наша позиція проста: це сильний інструмент для операційної автоматизації, особливо там, де бізнесу потрібні не тексти, а рішення. Але купувати назву моделі не треба. Купуйте перевірений результат на своїх даних.