Для бізнесу ця новина цікава не черговою гонкою бенчмарків. Суть в іншому. AI-агенти, які вміють працювати з кодом, інструментами й довгим робочим контекстом, поступово виходять із закритих екосистем у відкритий доступ. А отже, у SaaS-команд, агенцій автоматизації, внутрішніх IT-відділів і компаній, які не хочуть залежати від одного провайдера, з’являється більше варіантів.
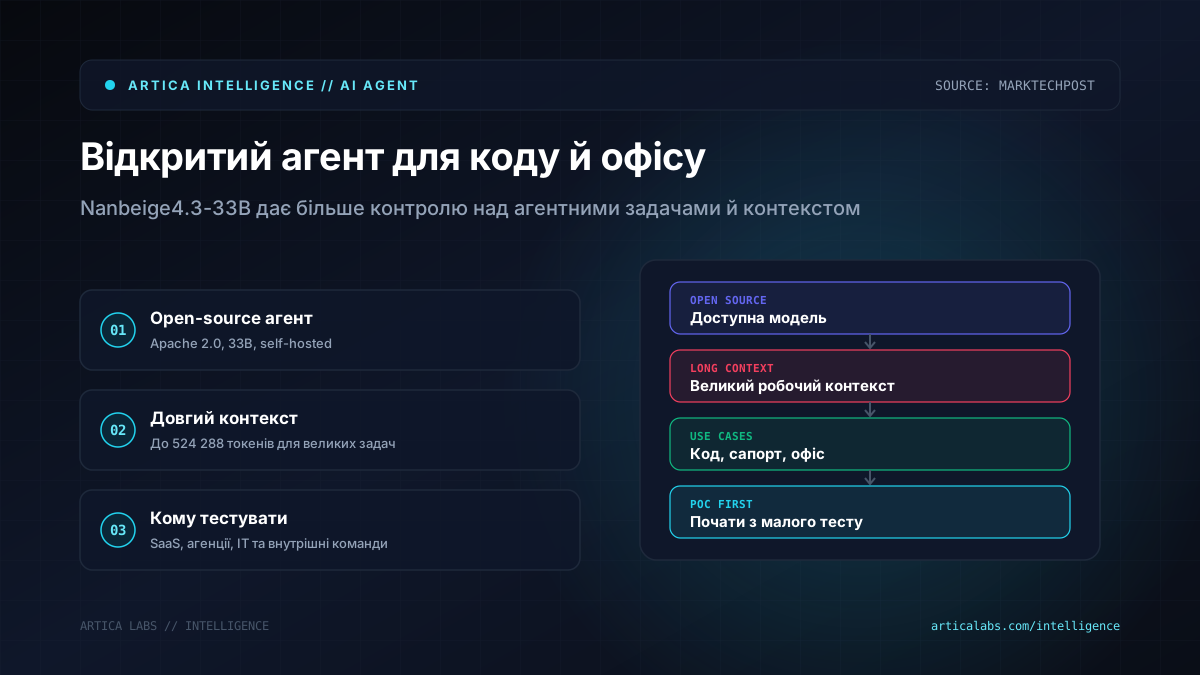
Як пише MarkTechPost, Nanbeige LLM Lab опублікувала на Hugging Face модель Nanbeige4.3-33B під ліцензією Apache 2.0. Лабораторія працює всередині рекрутингової платформи BOSS Zhipin. Модель має 33 млрд параметрів, щільну архітектуру без MoE і створена для agentic coding та офісних задач у форматі «AI-співробітника». Також доступна базова версія Nanbeige4.3-33B-Base для кастомного донавчання.
Довгий контекст — це не магія, але для роботи корисно
Nanbeige4.3-33B підтримує контекстне вікно 524 288 токенів. Простими словами, у модель можна завантажити дуже великий обсяг робочої інформації: репозиторій, документацію, логи, інструкції, історію задач. Для команди розробки це шанс краще працювати з великими кодовими базами. Для операційного менеджера — отримати агента, який бачить не один лист чи тикет, а ширший шмат процесу.
Уявімо службу доставки. Є заявки, статуси, шаблони відповідей, правила компенсацій і внутрішні SOP. Агент із великим контекстом теоретично може не лише відповісти клієнту, а й перевірити логіку дій, запропонувати зміну в процесі або підготувати інструкцію для оператора. У клініці схожий сценарій може стосуватися внутрішніх регламентів запису й комунікації з пацієнтами. В агенції — аналізу технічного завдання, CRM-процесу та коду інтеграції.
За даними Nanbeige, модель лідирує у 17 із 20 рядків власного порівняння з відкритими моделями близько 30B. На Terminal-Bench 2.1 вона набрала 80.9 проти 73.0 у Qwen3.8-27B. На Automation Bench — 54.2 проти 38.3, на JobBench — 44.8 проти 34.5. Є й слабші місця. На SWE-Bench Pro Nanbeige4.3-33B поступається Qwen3.8-27B, 60.3 проти 61.7. А Terminal-Bench 4.0 показав 23.8, і це найнижчий результат моделі в наведеній таблиці.
Кому є сенс тестувати Nanbeige4.3-33B вже зараз
Насамперед ця модель цікава технічним командам, які вже працюють із self-hosted LLM або мають причини тримати дані ближче до власної інфраструктури. Скажімо, SaaS-стартапу, який хоче поекспериментувати з кодовим агентом для pull request, автотестів чи міграцій. Або компанії, що будує внутрішнього помічника для n8n/Make-сценаріїв, документації та технічної підтримки.
І тут починається найцікавіше. 33B dense-модель — це не історія з розряду «запустили на ноутбуці й поїхали». У рецептах для SGLang і vLLM згадується 4-way tensor parallelism, тобто multi-GPU сервери. BF16-ваги потребують приблизно 66 ГБ пам’яті за арифметикою MarkTechPost. Довгий контекст також має свою ціну: що більше токенів і паралельних сесій, то швидше росте споживання пам’яті.
Є ще один нюанс. Усі результати в таблиці Nanbeige є self-reported. Це не означає, що їм не можна довіряти. Але для бізнес-рішення цього замало. Ми б починали не з міграції процесів, а з невеликого тесту:
- взяти 2–3 реальні задачі з коду, підтримки або операцій;
- порівняти Nanbeige з моделлю, яку команда вже використовує;
- оцінити не лише якість відповіді, а й швидкість, вартість інфраструктури та стабільність tool calling;
- окремо перевірити, як модель поводиться на довгих діалогах і чи не «тягне» помилки з попереднього контексту.
Nanbeige також позиціонує 33B-модель як «teacher» для майбутньої Nanbeige4.3-3B. Якщо менша версія успадкує частину агентних навичок, вона може бути цікавішою для масового бізнесу. Поки що Nanbeige4.3-33B виглядає як сильний інструмент для R&D, технічних команд і компаній, які вже готові платити за інфраструктуру та контроль.